

Asistente documental privado
Haga preguntas a sus documentos desde una interfaz de conversación, en sus locales: respuestas con referencias, acceso por carpeta o por equipo.
Desde 16 GB de VRAMEnvío a los 27 países de la UE · Sin aranceles dentro de la UE · Garantía del fabricante
Estaciones de IA listas para usar desde 2.490 €, rigs multi-GPU y servidores: hardware nuevo probado, configurado según sus modelos y su software, entregado o alojado.

Estación de IA Threadripper1 a 3 NVIDIA RTX PRO 6000 Blackwell 96 GB
desde 48.990 € sin IVAReserva con un anticipo reembolsable de 500 €
Estimación orientativa: 60 % de ocupación, electricidad a 0,20 €/kWh y comisión deducidas. Ingresos variables, no garantizados.
Cuatro configuraciones sencillas, montadas y probadas por nosotros con componentes nuevos: usted conecta la estación, abre la interfaz de conversación en su navegador y trabaja. Sus datos permanecen en sus instalaciones.
1× NVIDIA RTX 5060 Ti 16 GB
Qwen3 8B / 14BGemma 3 12Bgpt-oss-20bQwen3-VL 8BFlux
Asistente documental privado, primeros proyectos de IA, de 1 a 3 usuarios.
1× NVIDIA RTX 5070 Ti 16 GB
Qwen3 8B / 14BGemma 3 12Bgpt-oss-20bMistral Small 24BFlux
Respuestas e imágenes notablemente más rápidas, para un equipo pequeño.
2× NVIDIA RTX 5060 Ti 16 GB
Qwen3 32BQwen3-VL 32BGemma 3 27BQwen3-30B-A3BDeepSeek-R1 32B
Modelos de 30 mil millones de parámetros, visión y documentos, dos modelos en paralelo.
2× NVIDIA RTX 5070 Ti 16 GB
Qwen3 32BQwen3-VL 32BGemma 3 27BQwen3-30B-A3BFlux
Varios usuarios simultáneos, asistentes rápidos, imágenes y vídeo.
Para modelos de 70 mil millones de parámetros o más: Threadripper de 24 núcleos, de 1 a 3 NVIDIA RTX PRO 6000 Blackwell de 96 GB, 128 o 256 GB de RAM ECC. Bajo presupuesto, desde 21.990 € sin IVA, reserva mediante un anticipo de 500 €, reembolsado si usted renuncia. Servidores de 8 GPU también bajo presupuesto.
Precios con IVA incluido; montaje, instalación (Linux, controladores NVIDIA, Ollama, interfaz Open WebUI) y prueba de carga incluidos. Producto nuevo, probado y entregado en 7 días laborables. Instalación en sus locales, alojamiento en nuestras instalaciones o conexión a sus documentos: bajo presupuesto.
Haga preguntas a sus documentos desde una interfaz de conversación, en sus locales: respuestas con referencias, acceso por carpeta o por equipo.
Desde 16 GB de VRAMEjecuta Llama, Mistral, Qwen o DeepSeek en tus propias máquinas: tus datos se quedan contigo.
16 a 96 GB de VRAMGeneración de imágenes y vídeos (Stable Diffusion, Flux…), upscaling y edición acelerada.
De 16 a 32 GB de VRAMAdapta un modelo a los datos de tu negocio con LoRA o con un entrenamiento completo en varias GPU.
48 GB o más, multi-GPURenderizado 3D, simulación, cálculo científico: la potencia en paralelo de las GPU al servicio de tus proyectos.
Según el softwareUna estación de sobremesa en una carcasa cerrada, para consultar su documentación desde una interfaz de conversación: documentos, índices y respuestas permanecen en sus instalaciones. Estación entregada lista para usar; conexión a sus documentos e instalación bajo presupuesto.
Estación Esencial 16 GB desde 2.490 € IVA incluido · conexión a sus documentos bajo presupuestoServidores NVIDIA de 8 GPU (RTX PRO 6000 Blackwell, L40S, HGX B300) para inferencia y entrenamiento en empresas. Configurados y entregados bajo presupuesto.
 Bajo presupuesto
 Bajo presupuesto
 Bajo presupuesto
 Bajo presupuesto
 Bajo presupuesto
 Bajo presupuesto
 Bajo presupuesto
 Bajo presupuesto
Rigs multi-GPU listos para usar y chasis abiertos para montar tu propia estación de cálculo.


Tarjetas gráficas y PC equipados, por unidades, para completar una estación existente.
Ver todo (42)Fuentes de alimentación de servidor y ATX de alta potencia, breakout boards y cables para alimentar varias GPU con seguridad.


Placas base multi-PCIe para rigs y estaciones de cálculo, con los procesadores y memorias compatibles.


Procesadores y memoria RAM para completar una estación: el resto de componentes está en la colección Memorias.
Modelos que quieres ejecutar, software, presupuesto, limitaciones de espacio o de electricidad: basta una llamada para definir tu proyecto y proponerte una configuración adecuada.
La VRAM determina el tamaño del modelo que puedes cargar. Órdenes de magnitud para ejecutar un modelo de lenguaje (solo los pesos, sin contexto largo).
Valores orientativos: calcula entre un 10 y un 30 % más para el contexto y el procesamiento por lotes. El entrenamiento requiere bastante más memoria.
Antes de elegir una máquina, vea lo que pasa dentro: nuestras visitas 3D y nuestras guías muestran cómo un modelo de lenguaje produce su respuesta, qué hace una GPU mientras tanto, cuánto puede rendir y cómo equiparse bien.
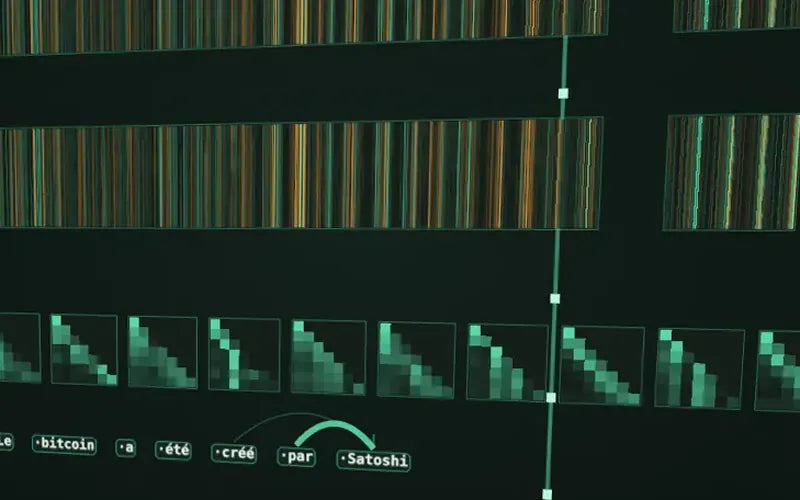 Visita 3D
Siga una frase dentro de un modelo de IA real: división en tokens, atención, 24 capas y elección de la palabra siguiente.
Iniciar la visita 3D Vista explosionada 3D
Del servidor de 8 GPU hasta el Tensor Core: el chip GH100, sus 141 GB de memoria HBM3e y el recorrido de los datos durante un cálculo de IA.
Explorar el H200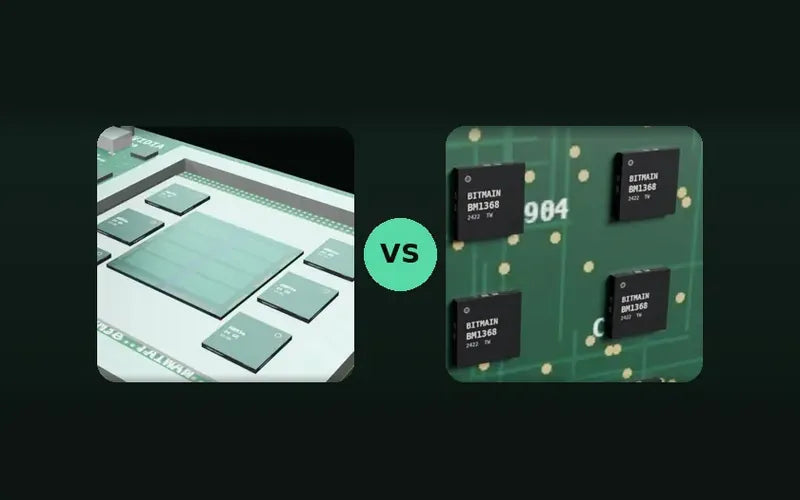 Guía
Por qué una GPU ejecuta cualquier modelo, por qué un Antminer no puede y dónde se sitúan las TPU de Google.
Leer la comparativa Herramienta
Lo que rinde una GPU alquilada para IA, descontada la electricidad: ingresos mensuales netos y plazo de amortización, modelo por modelo.
Calcular mi rentabilidad Guía
Lo que cambia para la confidencialidad una IA que funciona en sus propias instalaciones, lo que no cambia y el equipo que hay que prever.
Leer la guía Guía
Nuestra selección actualizada cada mes: qué modelo abierto ejecutar con 16, 32 o 96 GB, o en un servidor.
Leer la guía Guía
Memoria de vídeo, tarjeta gráfica, procesador: cómo elegir la máquina según los modelos que busca.
Leer la guía Guía
Nube por horas, máquina en sus instalaciones o alojada en Francia: el cálculo para elegir la opción correcta.
Leer la guía Guía
Cómo una cadena de bloques certifica una imagen, un conjunto de datos o una decisión de IA, explicado en 3D.
Leer la guíaModelos, software, volumen de datos, presupuesto y limitaciones de instalación (ruido, electricidad, espacio).
Te proponemos las GPU, la memoria, el almacenamiento y la alimentación adecuados, con un presupuesto detallado.
La máquina se monta, se actualiza y se prueba bajo carga antes del envío.
Se entrega lista para usar en Francia y en Europa, o se aloja y se mantiene en nuestras instalaciones.
Una tarjeta de 16 GB basta para los modelos de hasta 14 mil millones de parámetros y para un asistente documental. 32 GB, por ejemplo dos tarjetas de 16 GB, cubren los modelos de unos 30 mil millones de parámetros cuantizados y la generación de imágenes. Los modelos de 70 mil millones requieren de 48 a 96 GB o varias GPU. La guía de VRAM anterior da los órdenes de magnitud, y nuestra visita 3D de un LLM muestra lo que el modelo hace con esa memoria.
La GPU suelta completa una estación existente. El rig reúne varias tarjetas en una máquina dimensionada para ellas (alimentación, refrigeración). El servidor de IA de 8 GPU está pensado para la empresa: fiabilidad, interconexión rápida entre las tarjetas y funcionamiento continuo. Para ver lo que hay dentro de un servidor así, explore la GPU NVIDIA H200 en 3D.
Sí. Envíanos tu software, tus modelos, tus necesidades de memoria y tus limitaciones de instalación: estudiamos una configuración adecuada y te enviamos un presupuesto.
Sí, igual que nuestros mineros: la máquina puede alojarse, alimentarse y supervisarse en nuestras instalaciones, con acceso remoto.
Dos RTX 5060 Ti o RTX 5070 Ti de 16 GB ofrecen 32 GB de VRAM por bastante menos que una RTX 5090, hoy escasa y cara. Ollama, llama.cpp o vLLM reparten el modelo entre las dos tarjetas, y usted también puede ejecutar dos modelos a la vez, uno por tarjeta. Una sola tarjeta de 32 GB sigue siendo más rápida con un modelo grande: la ofrecemos bajo presupuesto, según disponibilidad.
No. Un Antminer solo sabe calcular el SHA-256 de bitcoin: no tiene memoria para los pesos de un modelo ni unidades para multiplicar matrices. La IA requiere GPU, o ASIC diseñados para ella como las TPU de Google, que no se venden libremente. Nuestra comparativa ASIC o GPU explica por qué, chip por chip.
Depende del modelo de tarjeta, de la tasa de ocupación y de su precio de la electricidad. Nuestra calculadora de rentabilidad de GPU estima los ingresos mensuales netos y el plazo de amortización, modelo por modelo. Son estimaciones indicativas, no una garantía de ingresos.
Cuéntanos tus modelos, tu software y tu presupuesto: te proponemos una configuración probada, entregada o alojada.
¡Gracias por suscribirte!
¡Este correo ya está registrado!


